


こんにちは、CloudNative Days実行委員の岡本恵人です。
GameDayにご参加いただいた皆さま、ありがとうございました!この記事では、GameDayの企画背景から各Questの解説までをご紹介します。
企画背景
以前、別のカンファレンスで開催したGameDayが好評でした。特に「実際に使われているソフトウェアに触れられて学びが多かった」というフィードバックを、初学者の方を含む幅広い参加者からいただきました。
そこで、初学者から経験者までがチームで一緒にクラウドネイティブ技術に触れ、学びを得られる場として、CNDW2026でもGameDayを開催することにしました。
今回のGameDayで意識したこと
好評だった点はそのまま引き継ぎました。具体的には、Kubernetesを操作できる環境をブラウザ上で用意したことと、チーム内で自然にコミュニケーションやディスカッションが生まれる形式にしたことです。
今回はさらに、「Podのエラーに対応せよ」のような直接的な設問は避けました。代わりに「不正検知のアラートが来ない」「価格表示が遅い」といった、実際の問い合わせ対応に近いシナリオとして設問を作っています。
また、障害の原因の多くは、マージ済みのPRとしてチームのリポジトリに入れておきました。クラスタの状態を確認するだけでなく、コミット履歴をたどれば、どんな変更が障害につながったのかがわかります。GitOpsでは変更の記録が残るので、その利点を生かせる設計にしました。
ただし、履歴を見ただけで原因を決めつけられないように、障害と関係のないPRや、原因となった修正に似ているものの正常に動作するPRも混ぜて、難易度を調整しています。
障害の特定から自分たちの手で取り組むことで、より多くの経験を持ち帰っていただきたい。そんな思いで問題を作りました。
GameDay の構成概要
本 GameDay は OpenTelemetry Demo をベースとした EC マイクロサービス構成( frontend 、 frontend-proxy 、 cart 、 checkout 、 payment 、 product-catalog 、 recommendation 、 ad などのサービス群)を題材としています。各チームには専用の Kubernetes namespace と、ブラウザから操作できる Code Server / Grafana / Jaeger / ArgoCD / GitHub リポジトリが用意されており、注入された障害を発見・修正してスコアを競う形式で進行しました。
- Quest 数 : 全 13 問
- 合計配点 : 5,600 pt
- カテゴリ : tutorial / gitops / workload / networking / observability
- 難易度 : tutorial / normal / hard / lunatic
- 基本フロー : 障害発見 → GitHub のマニフェスト修正 → commit & push → ArgoCD が自動同期 → Verifier で合否判定
参加者の kubectl は読み取り専用で、設定の変更はすべて GitHub 経由で行います。設定を変更せずに Pod を作り直す操作(Pod の削除や Deployment の Restart)は、ArgoCD UI から行えます。
用語の説明
本記事に登場する GameDay 環境固有の用語を整理します。
- team namespace : 各チームに割り当てられた Kubernetes namespace。Pod・Service・Deployment などのリソースはすべてこの namespace 内に閉じています。
- Code Server : ブラウザ上で利用できるエディタ環境。ターミナルから
kubectlを実行したり、GitHub リポジトリのマニフェストを編集したりするのに使います。 - Verifier : 各 Quest の合否を自動判定するシステム。クラスタの状態や HTTP/TCP 応答、Jaeger のトレースなどをチェックし、所定の条件を満たせば合格となります。
- ArgoCD : GitOps による自動デプロイを担うコンポーネント。GitHub リポジトリの変更を検知して Kubernetes にマニフェストを適用します。
- ヒント (L1 / L2 / L3) : 各 Quest にはレベル別のヒントが用意されており、開示するとその cost 分が配点から差し引かれます(最低点は配点の 30%)。今回はヒントを気軽に開いてもらえるよう、すべて開いても配点の 10% 程度しか減らない設定にしました。tutorial のヒントは無料です。
Quest 一覧
| ID | Slug | カテゴリ | 難易度 | 対象 | 配点 |
|---|---|---|---|---|---|
| quest-01 | pod-count | tutorial | tutorial | - | 200 |
| quest-02 | trace-deps | tutorial | tutorial | recommendation | 200 |
| quest-03 | top-service | tutorial | tutorial | - | 200 |
| quest-04 | gitops-deploy | gitops | tutorial | cart | 200 |
| quest-05 | fix-image | workload | normal | payment | 300 |
| quest-06 | fix-toleration | workload | normal | accounting | 300 |
| quest-07 | fix-quota | workload | normal | fraud-detection | 400 |
| quest-08 | fix-run-as-non-root | workload | normal | ad | 400 |
| quest-09 | fix-service-port | networking | normal | 400 | |
| quest-10 | fix-trace-filter | observability | hard | otel-collector | 700 |
| quest-11 | fix-cpu-throttling | workload | hard | currency | 700 |
| quest-12 | fix-env-cleanup | workload | lunatic | image-provider | 800 |
| quest-13 | fix-dns-ndots | networking | lunatic | slo-reporter | 800 |
quest-01 (pod-count) — 環境を確認せよ
- カテゴリ : tutorial
- 難易度 : tutorial
- 配点 : 200 pt
- ヒント : なし
シナリオ
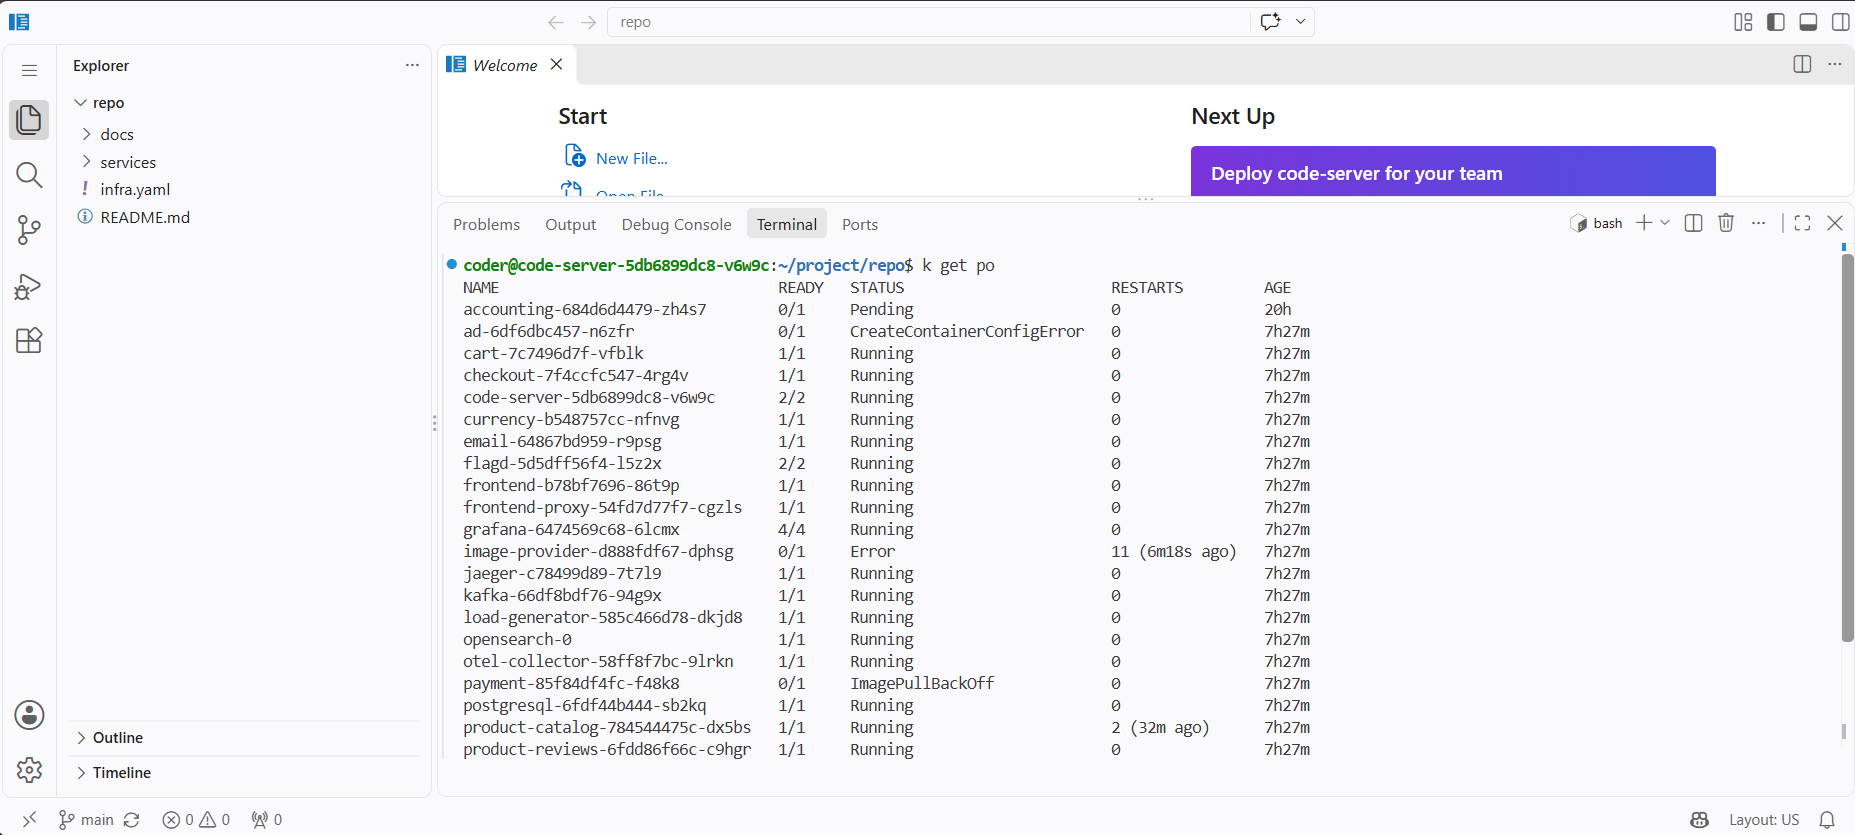
Code Server のターミナルを開いて kubectl get pods を打ち、チームの namespace で Ready 状態の Pod が何個あるかを答えるチュートリアルです。
障害の内容
障害注入なし。 環境確認が目的です。ただし他の Quest の障害で起動していない Pod(payment、accounting など)があるので、すべての Pod が Ready なわけではありません。
想定の解き方
- Code Server のターミナルを開く
-
kubectl get podsを実行し、STATUS がRunningかつ READY 列が1/1や2/2のように全コンテナ Ready な Pod の数を数える - 数えた Pod の数を回答に提出
Verifier の合格条件
Verifier は回答時点の namespace の Ready な Pod 数を取得し、回答との差が 1 以内 であれば合格です。slo-reporter の Job の Pod が実行中の数秒間だけ Ready になるなど、数え終わるまでに数が変動することがあるため、誤差 ±1 を許容しています。
quest-02 (trace-deps) — サービスの依存関係を調べよ
- カテゴリ : tutorial
- 難易度 : tutorial
- 配点 : 200 pt
- ヒント : L1=0 / L2=0
シナリオ
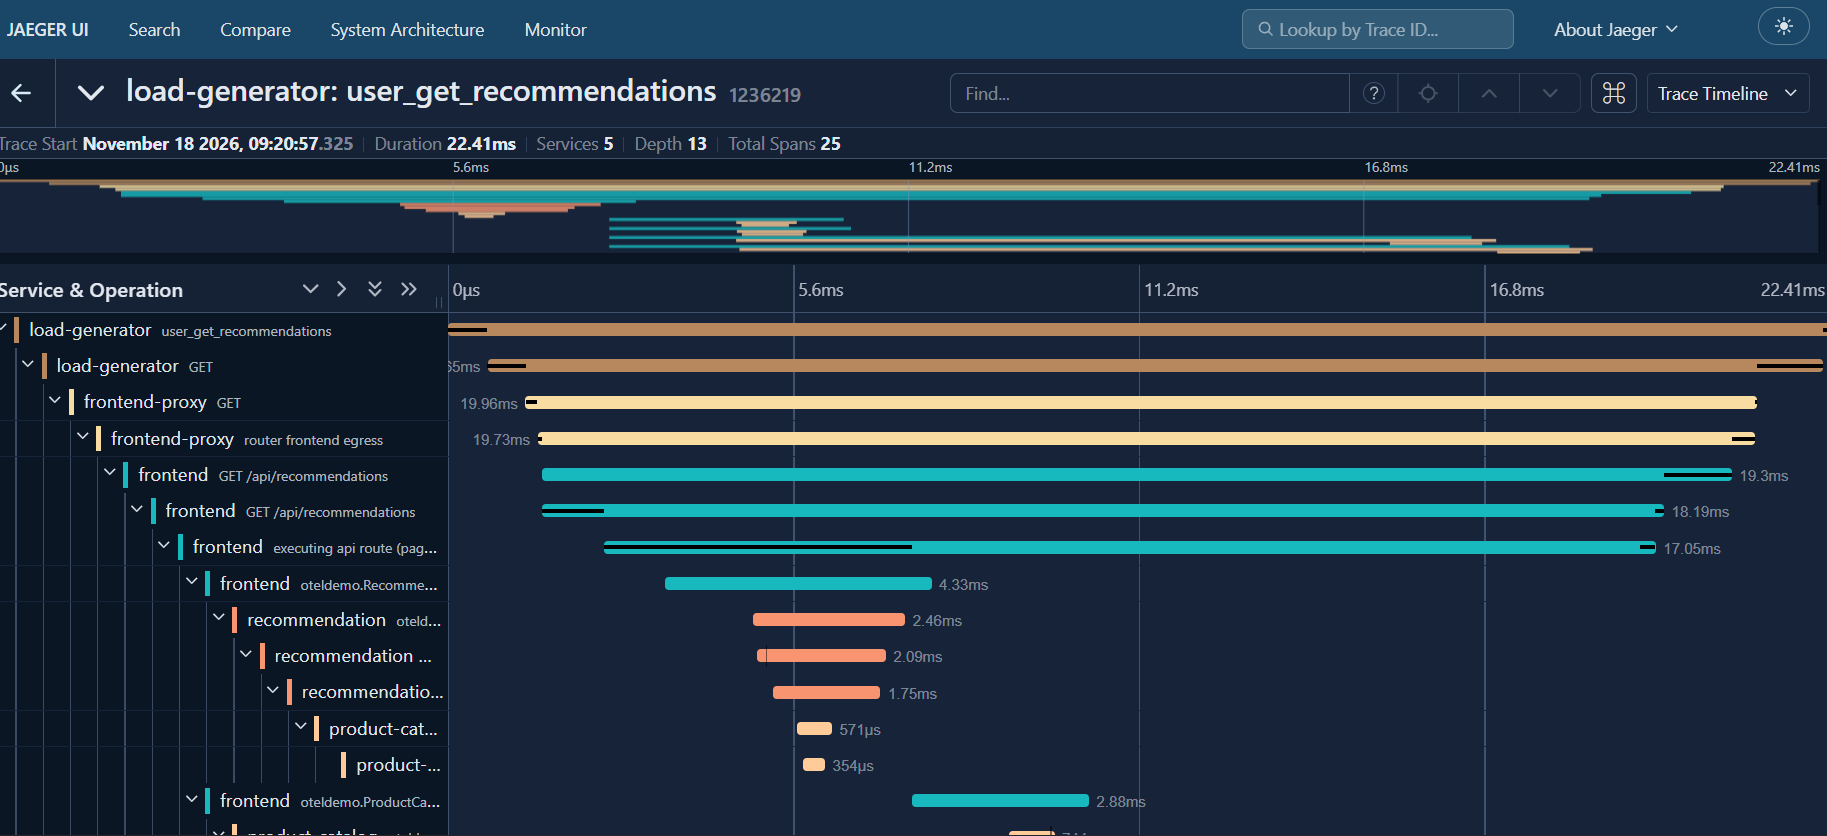
障害の影響範囲を素早く把握するには、サービス間の依存関係の理解が欠かせません。Jaeger で分散トレースを確認し、 recommendation サービスを直接呼び出しているサービスを答えます。
障害の内容
障害注入なし。 Jaeger UI でスパンの親子関係を読み解く観察クエストです。
想定の解き方
-
https://<your-team>.gameday.cloudnativedays.jp/jaeger/ui/にアクセス - Service を
recommendationに絞ってFind Tracesを実行 - 任意のトレースを開き、
recommendationスパンの親スパン(一段上)が何サービスか確認する - そのサービス名(
frontend)を回答する
Verifier の合格条件
回答が frontend と一致すれば合格です(大文字と小文字は区別しません)。
quest-03 (top-service) — リクエスト数が多いサービスを特定せよ
- カテゴリ : tutorial
- 難易度 : tutorial
- 配点 : 200 pt
- ヒント : L1=0 / L2=0
シナリオ
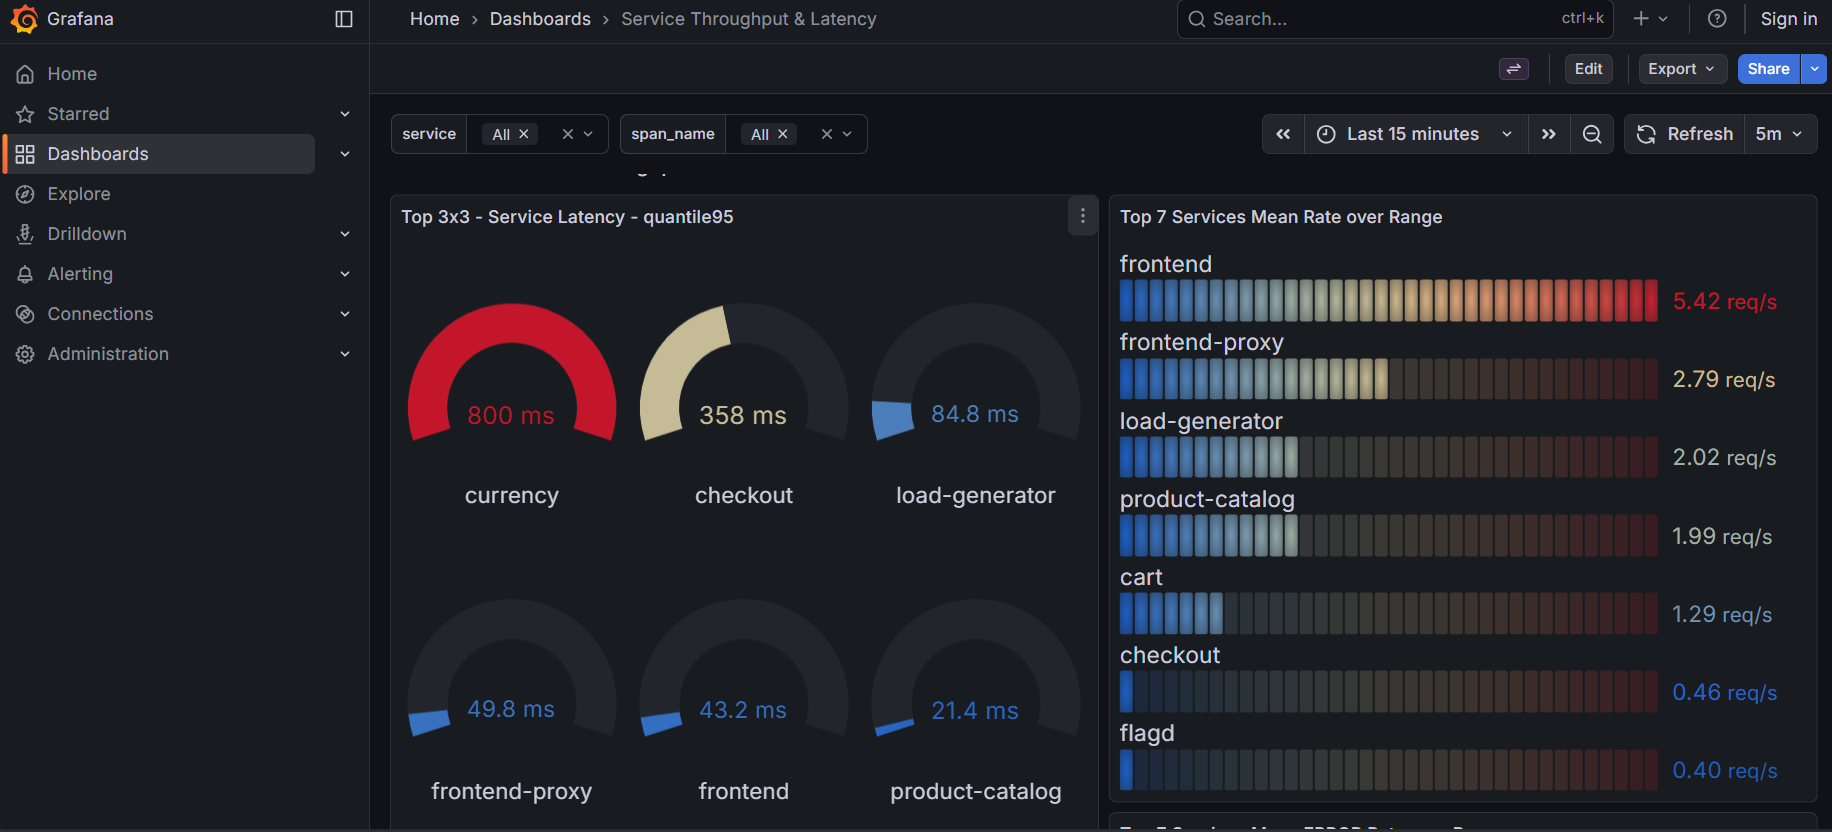
Grafana のダッシュボードで、 frontend と frontend-proxy を除いて、直近のリクエスト数(throughput)が最も多いサービスを 1 つ答えます。
障害の内容
障害注入なし。 Grafana でメトリクスを読む観察クエストです。
想定の解き方
- Grafana の Dashboards から
Service Throughput & Latencyダッシュボードを開く - 表示期間は既定の「Last 15 minutes」、service と span_name の選択は「All」のままにする
- 「Top 7 Services Mean Rate over Range」パネルで、
frontendとfrontend-proxyを除いた 1 位のサービスを確認する - 回答する直前にダッシュボードを更新し、そのサービス名を回答する
Verifier の合格条件
この Quest の正解は固定していません。 frontend と frontend-proxy を除いた各サービスの throughput を 15 分と 5 分の 2 通りの期間で比べ、どちらかの期間で、回答したサービスの throughput が 1 位の 85% 以上 であれば合格です。ダッシュボードを読んでから回答するまでに順位が入れ替わっても不合格にならないよう、僅差のサービスはどちらも正解にしています。
quest-04 (gitops-deploy) — 変更をデプロイせよ
- カテゴリ : gitops
- 難易度 : tutorial
- 配点 : 200 pt
- ヒント : なし
シナリオ
チームの GitHub リポジトリに「cart に readinessProbe を追加する」PR が出ています。内容をレビューして main にマージし、ArgoCD の自動同期でクラスタに反映させます。
障害の内容
障害注入なし。 GitOps フロー(PR レビュー → マージ → ArgoCD 自動同期)を体験するクエストです。PR の中身は次の変更です。
containers:
  - name: cart
    readinessProbe:
      grpc:
        port: 8080
      initialDelaySeconds: 10
      periodSeconds: 10
想定の解き方
- チームの GitHub リポジトリを開き、open になっている PR の差分を確認する
- PR をマージする
- ArgoCD UI で Application が
Syncedになり、cartの Pod が Ready になることを確認する
Verifier の合格条件
- ArgoCD Application が
Syncedであること(他の Quest の障害で Healthy にはならないので、Healthy は見ません) -
cartDeployment に readinessProbe が設定されていること -
cartDeployment のavailableReplicas >= 1であること
quest-05 (fix-image) — 注文が確定できない
- カテゴリ : workload
- 難易度 : normal
- 配点 : 300 pt
- ヒント : L1=10 / L2=20
シナリオ
カスタマーサポートに「注文の確定ボタンを押すとエラーになる」という問い合わせが相次いでいます。決済チームによると、 payment の Pod が起動していないようです。
障害の内容
payment Deployment のイメージタグが、存在しない 2.2.0-paaaayment になっています。難易度調整のため、この障害は PR ではなく初期コミットに入っています。
# 障害が入った状態
containers:
  - name: payment
    image: ghcr.io/open-telemetry/demo:2.2.0-paaaayment  # ← 存在しないタグ

# 正しい状態
containers:
  - name: payment
    image: ghcr.io/open-telemetry/demo:2.2.0-payment
ghcr.io に :2.2.0-paaaayment というタグは存在しないため、kubelet がイメージを Pull できません。
観測されるはずの症状
NAME              READY   STATUS             RESTARTS   AGE
payment-xxx-xxx   0/1     ImagePullBackOff   0          30m
kubectl describe pod <payment-pod> の Events:
Normal   BackOff  3m45s (x945 over 3h38m)  kubelet  Back-off pulling image "ghcr.io/open-telemetry/demo:2.2.0-paaaayment"
Warning  Failed   3m45s (x945 over 3h38m)  kubelet  Error: ImagePullBackOff
Webstore で商品をカートに入れて「Place Order」を押しても、注文完了の画面に進みません。
想定の解き方
-
kubectl get podsでpaymentがErrImagePull/ImagePullBackOffになっていることを確認する -
kubectl describe pod <payment-pod>の Events で、Pull に失敗したイメージ名を確認する(ArgoCD UI のリソースツリーで Pod を開き、EVENTS タブでも確認できます) -
services/payment.yamlのimageを2.2.0-paymentに修正する - commit & push → ArgoCD が自動同期 → Pod が
Runningになる
Verifier の合格条件
-
paymentDeployment のavailableReplicas > 0であること -
paymentPod の restart 合計が 5 以下であること
quest-06 (fix-toleration) — 会計の集計が更新されない
- カテゴリ : workload
- 難易度 : normal
- 配点 : 300 pt
- ヒント : L1=5 / L2=10 / L3=15
シナリオ
経理チームから「今朝から会計の集計が更新されていない」と連絡がありました。基盤チームは以前から、非同期バッチ系のワークロードを専用ノードプールに移す方針を全チームに通知し、各サービスの移行作業を進めていました。
障害の内容
クラスタには全チームで共有するバッチ用ノードがあり、taint workload=batch:NoSchedule とラベル workload=batch が付いています。
基盤チームの移行 PR( chore(accounting): batch 用ノードプールに移行する )で、 accounting Deployment に nodeSelector だけが追加され、taint を許容する toleration は追加されていませんでした。
# 障害が入った状態
spec:
  template:
    spec:
      nodeSelector:
        workload: batch
batch ノードには toleration がないので Scheduling されず、他のノードには nodeSelector が合わないので Scheduling されません。結果として Pod はどのノードにも割り当てられません。
観測されるはずの症状
NAME                 READY   STATUS    RESTARTS   AGE
accounting-xxx-xxx   0/1     Pending   0          30m
kubectl describe pod <accounting-pod> の Events:
0/N nodes are available: X node(s) didn't match Pod's node affinity/selector, Y node(s) had untolerated taint(s).想定の解き方
-
kubectl describe pod <accounting-pod>の Events で、untolerated taint(s)を確認する - Deployment の
nodeSelectorがworkload: batchであることを確認する -
kubectl get nodes -L workloadやkubectl get nodes -l workload=batchで batch ノードを探す -
kubectl describe node <batch ノード>のTaintsでworkload=batch:NoScheduleを確認する -
nodeSelectorは残したまま、services/accounting.yamlに toleration を追加する
spec:
  template:
    spec:
      nodeSelector:
        workload: batch
      tolerations:
        - key: workload
          operator: Equal
          value: batch
effect: NoSchedule- commit & push → ArgoCD 同期 → batch ノードで Pod が起動する
Verifier の合格条件
-
accountingDeployment にnodeSelector: {workload: batch}が設定されたままであること -
accountingDeployment のavailableReplicas >= 1であること -
accountingの Pod が動作しているノードにworkload=batchラベルが付いていること
nodeSelector を削除して一般ノードで動作させる修正は、基盤チームの方針に反するので不合格です。
quest-07 (fix-quota) — 不正検知のアラートが来ない
- カテゴリ : workload
- 難易度 : normal
- 配点 : 400 pt
- ヒント : L1=15 / L2=25
シナリオ
不正検知チームから「昨日から不正注文のアラートが 1 件も来ない。JVM のヒープ不足が心配だったので、とりあえずメモリを増やしておいた」と連絡がありました。基盤チームは namespace ごとに ResourceQuota と LimitRange を配布しています。
障害の内容
namespace には、基盤チームが配布した ResourceQuota と LimitRange が最初から存在します( services/namespace-quota.yaml )。
apiVersion: v1
kind: ResourceQuota
metadata:
  name: team-quota
spec:
  hard:
    requests.memory: 12Gi       # namespace 全体の上限
---
apiVersion: v1
kind: LimitRange
metadata:
  name: team-limits
spec:
  limits:
    - type: Container
      max:
        memory: 2Gi             # 1 コンテナあたりの上限
      defaultRequest:
        memory: 16Mi
      default:
        memory: 64Mi
そこへ不正検知チームの PR( chore(fraud-detection): メモリを増やす )で、 fraud-detection のメモリが 999Gi に変更されました。
# 障害が入った状態
resources:
  requests:
    memory: 999Gi
  limits:
    memory: 999Gi
1 コンテナあたりの上限 2Gi を超えるので、Pod の作成が LimitRange で拒否されます。
観測されるはずの症状
kubectl get pods に fraud-detection の Pod が 1 つも表示されません。
kubectl describe rs <fraud-detection の ReplicaSet> の Events:
pods "fraud-detection-..." is forbidden: maximum memory usage per Container is 2Gi, but limit is 999Gi想定の解き方
-
kubectl get podsにfraud-detectionがないことに気づき、kubectl get deploy,rsで ReplicaSet を確認する -
kubectl describe rs <fraud-detection の ReplicaSet>の Events で、LimitRange による拒否を確認する(ArgoCD UI のリソースツリーで ReplicaSet を開き、EVENTS タブでも確認できます) -
kubectl describe limitrangeで 1 コンテナあたりの上限を、kubectl describe quotaで namespace 全体の上限と使用量を確認する -
services/fraud-detection.yamlの requests と limits を、どちらの上限にも収まる適切な値に下げる
resources:
  requests:
    memory: 300Mi
  limits:
memory: 300Mi- commit & push → ArgoCD 同期
Verifier の合格条件
- ResourceQuota
team-quotaのrequests.memoryが 12Gi のままであること - LimitRange
team-limitsの 1 コンテナあたりの上限が 2Gi のままであること -
fraud-detectionDeployment のavailableReplicas >= 1であること
LimitRange や ResourceQuota を広げたり削除したりする修正は不合格です。
quest-08 (fix-run-as-non-root) — 広告が表示されない
- カテゴリ : workload
- 難易度 : normal
- 配点 : 400 pt
- ヒント : L1=15 / L2=25
シナリオ
広告配信チームから「昨日の夕方から、サイトに広告が 1 件も表示されていない。広告のコードは何も変更していない」と連絡がありました。
障害の内容
基盤チームのセキュリティ強化(ハードニング)の PR( chore(ad,shipping): runAsNonRoot を設定する(セキュリティ強化) )で、 ad のコンテナに runAsNonRoot: true だけが追加されました。
# 障害が入った状態
containers:
  - name: ad
    securityContext:
      runAsNonRoot: true
ad のイメージには USER の指定がなく、root で起動します。 runAsNonRoot: true は「root で起動するなら起動しない」という設定なので、kubelet はコンテナを起動しません。
同じ PR で shipping にも同じ設定が入っていますが、 shipping のイメージは UID 65532 で起動するため問題なく起動します。PR で追加された docs/security-hardening.md には、「適用後にサービスが起動しなくなった場合は、設定を外すのではなく、その段階の設定を満たしたまま動作するように修正する」という運用が書かれていました。
観測されるはずの症状
NAME         READY   STATUS                       RESTARTS   AGE
ad-xxx-xxx   0/1     CreateContainerConfigError   0          30m
kubectl describe pod <ad-pod> の Events:
Error: container has runAsNonRoot and image will run as root想定の解き方
-
kubectl describe pod <ad-pod>の Events で、上のメッセージを確認する - コミット履歴から、基盤チームのハードニング PR と
docs/security-hardening.mdを見つける -
runAsNonRoot: trueは残したまま、services/ad.yamlに 0 以外のrunAsUserとrunAsGroupを追加する
containers:
  - name: ad
    securityContext:
      runAsNonRoot: true
      runAsUser: 1000
runAsGroup: 1000- commit & push → ArgoCD 同期
Verifier の合格条件
-
adの Pod テンプレートでrunAsNonRoot: trueが設定されたままであること(Pod 単位とコンテナ単位のどちらで設定してもかまいません) -
runAsUserが 0 以外に設定されていること -
adDeployment のavailableReplicas > 0で、restart 合計が 5 以下であること
runAsNonRoot を外す修正は不合格です。
quest-09 (fix-service-port) — 注文確認メールが届かない
- カテゴリ : networking
- 難易度 : normal
- 配点 : 400 pt
- ヒント : L1=15 / L2=25
シナリオ
カスタマーサポートに「注文確認メールが届かない」という問い合わせが増えています。注文自体は成功しています。 email サービスには最近、社内ポート規約への移行が入りました。移行は維持したまま、注文確認メールが送信されるように修正します。
障害の内容
email のポート移行 PR( chore(email): ポートを社内ポート規約に移行する )で、リッスンポート( EMAIL_PORT )と containerPort が 9080 に変更されました。しかし Service の targetPort は 8080 のままです。
# Deployment(PR で変更された部分)
containers:
  - name: email
    ports:
      - containerPort: 9080
        name: service
    env:
      - name: EMAIL_PORT
        value: "9080"

# Service(変更されていない)
ports:
  - port: 8080
    name: tcp-service
    targetPort: 8080            # ← Pod は 8080 で待ち受けていない
Service に届いた通信は Pod の 8080 番ポートに転送されますが、Pod は 8080 番ポートではリスニング状態でないため、接続が拒否されます。
少し前には、同じ規約の移行を quote に適用した PR( chore(quote): ポートを社内ポート規約に移行する )がマージされていました。こちらは QUOTE_PORT 、 containerPort 、Service の targetPort をそろえて変更していたので、正しく動作しています。2 つの PR の差分を見比べることで、 email の PR では Service の targetPort を変更し忘れていることに気づくことも可能です。
観測されるはずの症状
-
emailの Pod はRunningで、再起動もしていない - 注文は完了するが、
emailのログに送信の記録が出ない -
checkoutのログや Jaeger のトレースで、emailへの呼び出しがconnection refusedで失敗している
kubectl get endpoints email を見ると、Endpoints が Pod の 8080 番ポートを指していることがわかります。
想定の解き方
-
checkoutのログや Jaeger で、emailへの接続が失敗していることを確認する -
kubectl get svc emailとkubectl get endpoints emailで Service の設定を確認し、Deployment のcontainerPortと比べる -
services/email.yamlの Service のtargetPortを修正する。ポート番号の変更に追従できる名前付きポートを使う修正を模範解答としています
ports:
  - port: 8080
    name: tcp-service
    targetPort: service         # containerPort の名前を指す(9080 と書いても可)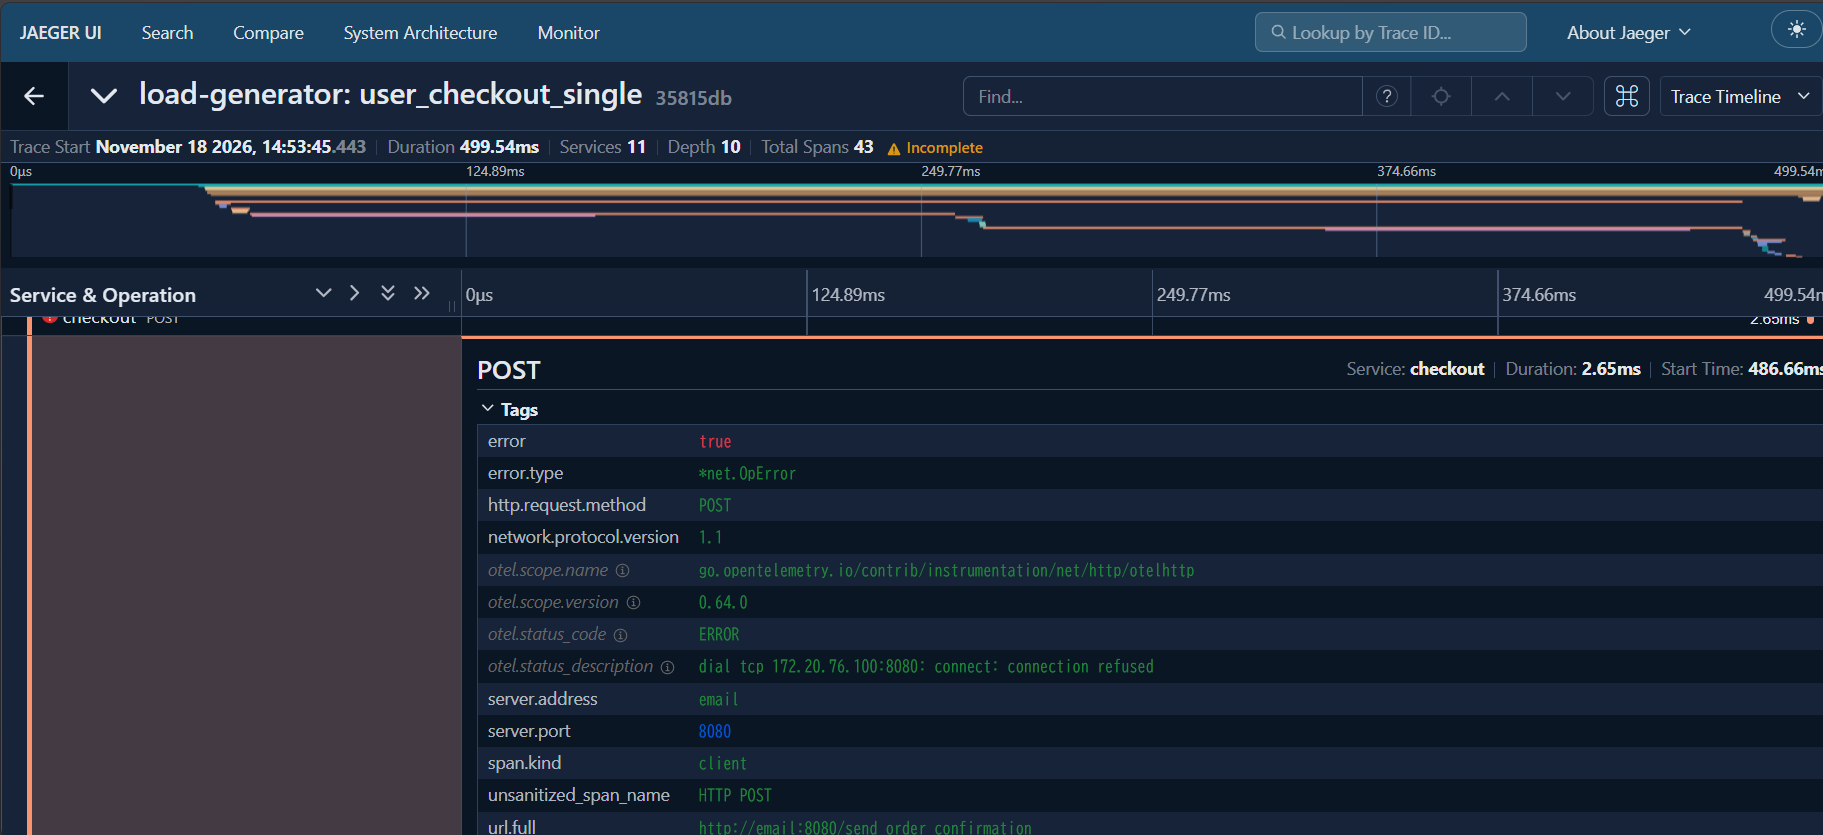
Verifier の合格条件
-
emailDeployment のemailコンテナのcontainerPortが 9080 のままであること -
emailService のいずれかのポートが、その containerPort に転送する設定になっていること。targetPortが9080か、containerPort の名前serviceであれば満たします。targetPortを省略した場合は、Service のportが 9080 であれば満たします - GM から 2 のポートの Service の
port(email.<team-ns>.svc.cluster.local:<port>)へ 50 ミリ秒おきに 40 回 TCP 接続し、成功率が 95% 以上 (失敗が 2 回以下)であること。Service のportは 8080 でも 9080 でも、その値に接続します。
Service の port を 9080 に変更した場合は、 checkout の EMAIL_ADDR もあわせて変更しないとメールは届きません。
Deployment 側を 8080 に戻す修正(PR の revert など)は、移行を維持していないので不合格です。
quest-10 (fix-trace-filter) — 注文処理のトレースが見つからない
- カテゴリ : observability
- 難易度 : hard
- 配点 : 700 pt
- ヒント : L1=20 / L2=20 / L3=30
シナリオ
決済チームから「注文の確定に時間がかかっているのではないか」と相談がありました。Jaeger で checkout の注文処理( PlaceOrder )を調べようとしても、該当する span が 1 本も見つかりません。オブザーバビリティチームは「先週、トレースの保存コストを下げるために、ヘルスチェックの span を取得しない設定を入れた」と話しています。
障害の内容
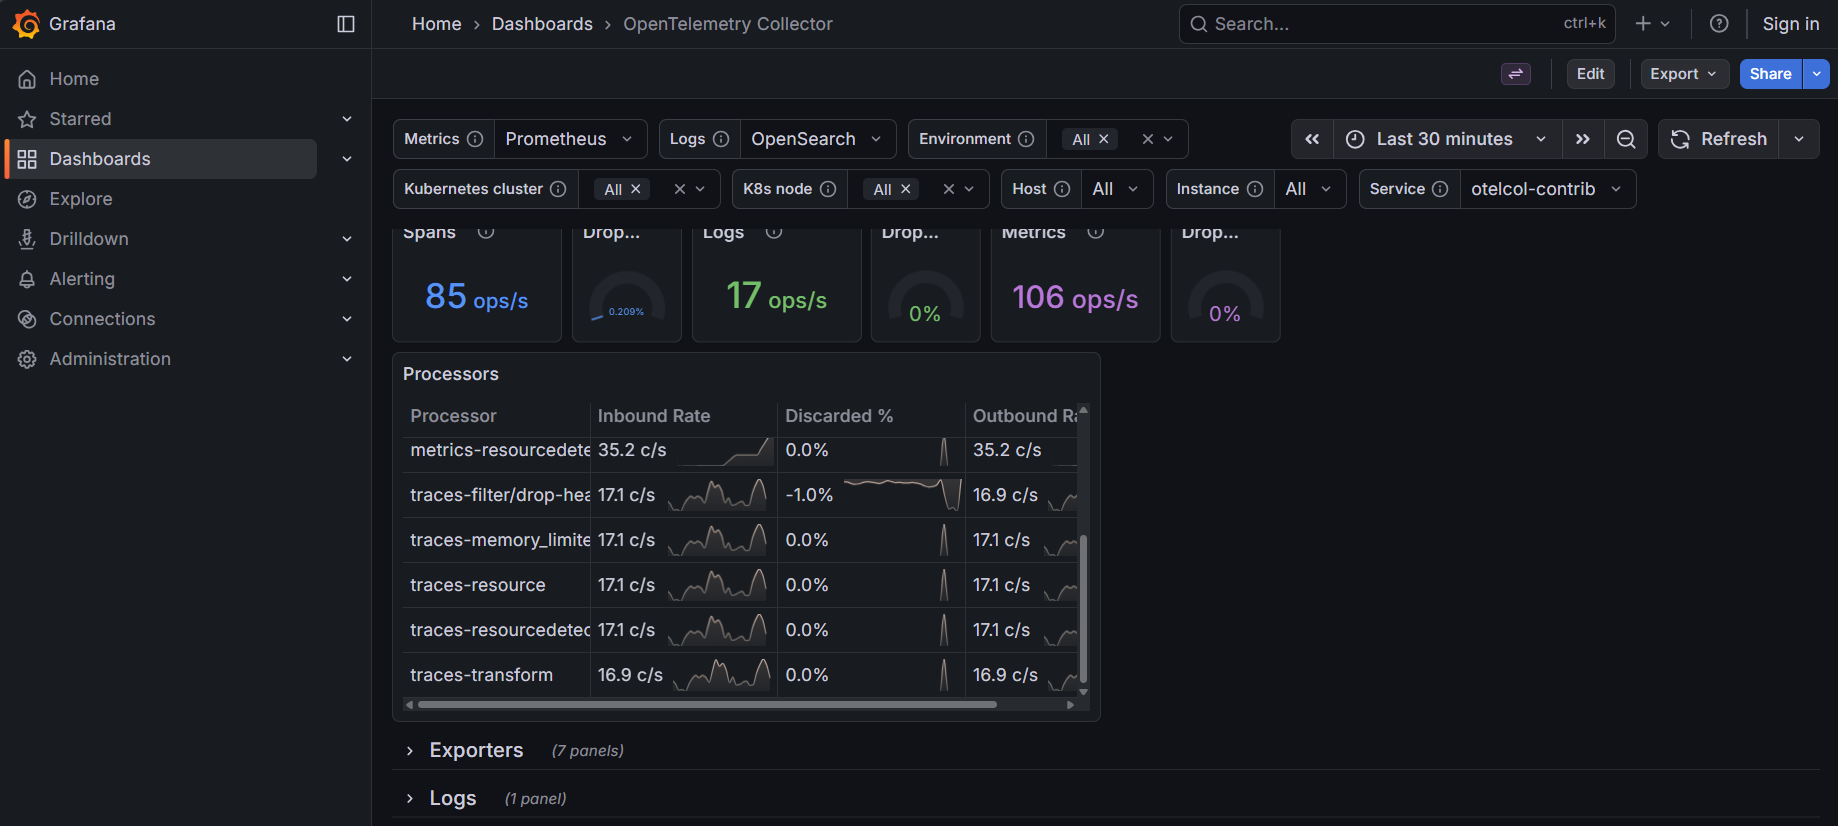
オブザーバビリティチームの PR( chore(otel-collector): ヘルスチェックの span を捨てる )で、otel-collector の traces pipeline に filter processor が追加されました。
processors:
  filter/drop-healthcheck:
    error_mode: ignore
    traces:
      span:
        - IsMatch(name, ".*Check.*")
PR の本文によると、捨てたかったのは gRPC のヘルスチェック( grpc.health.v1.Health/Check )の span です。しかし .*Check.* は oteldemo.CheckoutService/PlaceOrder にもマッチするので、注文処理の span まで捨てられていました。filter は spanmetrics connector より前にあるので、 PlaceOrder の span からはメトリクスも生成されません。
観測されるはずの症状
-
checkoutの Pod はRunningで、ログも出ている - Jaeger で Service を
checkoutにしても、Operation にoteldemo.CheckoutService/PlaceOrderが出てこない - Grafana の OpenTelemetry Collector ダッシュボードで、processor の入力数と出力数に差がある(
Drop Rateパネルで捨てられた割合も確認可能)
想定の解き方
-
checkout自体は正常に動作していることを確認し、テレメトリのパイプラインを調べる - コミット履歴からオブザーバビリティチームの PR を見つけ、
services/otel-collector.yamlの ConfigMap にある filter の条件を確認する - PR の意図どおり、ヘルスチェックの span だけを捨てるよう条件を完全一致に狭める
filter/drop-healthcheck:
  error_mode: ignore
  traces:
    span:
- name == "grpc.health.v1.Health/Check"- otel-collector の Pod を再作成する。otel-collector は設定ファイルを自動では読み直さないので、ConfigMap を変更しただけでは反映されません。次のどちらかで反映します
- Deployment の Pod テンプレートにある
checksum/configannotation の値を変更する(PR と同じ方法で、変更の記録を Git に保存できます) - ArgoCD UI で otel-collector の Pod を削除するか、Deployment の Restart アクションを実行する
- Deployment の Pod テンプレートにある
- Webstore で注文し、Jaeger で
PlaceOrderの span が出ることを確認する
Verifier の合格条件
- otel-collector の traces pipeline に filter processor が含まれ、条件が 1 つ以上設定されていること
- Jaeger API で、直近 5 分間の
checkoutのoteldemo.CheckoutService/PlaceOrderの span を取得できること
filter processor を削除する修正や、条件を空にする修正は不合格です。
quest-11 (fix-cpu-throttling) — 価格表示が遅い
- カテゴリ : workload
- 難易度 : hard
- 配点 : 700 pt
- ヒント : L1=20 / L2=20 / L3=30
シナリオ
ユーザーから「USD 以外の通貨を選ぶと、商品一覧の価格が表示されるまでに時間がかかる」という報告がありました。 currency の Pod は Running で、再起動もしていません。
障害の内容
currency Deployment の CPU の requests と limits が 10m になっています。難易度調整のため、この障害は PR ではなく初期コミットに入っています。
# 障害が入った状態
resources:
  requests:
    cpu: 10m
  limits:
    cpu: 10m
10m は Kubernetes が設定できる CFS quota の下限(100ms の周期で 1ms)です。 currency はリクエストのたびに CPU を使うので、limit に達して CFS の throttling がかかり、応答に時間がかかります。
観測されるはずの症状
-
currencyの Pod はRunningで、再起動もしていない - Webstore で通貨を USD 以外に切り替えると、商品一覧の価格が更新されるまでに時間がかかる
- Jaeger でトレースを見ると、
currencyの span だけが長い
想定の解き方
- Jaeger で、トレース全体のどの span が長いかを確認し、
currencyを特定する -
currencyの span だけが長いので、アプリの処理ではなく実行環境に原因があると考える -
kubectl describe pod <currency-pod>で Requests と Limits を確認し、他のサービスより極端に小さいことに気づく -
services/currency.yamlの CPU limit を引き上げる(または削除する)
resources:
  requests:
    cpu: 100m
  limits:
cpu: 500m- commit & push → ArgoCD 同期
今回は解決方法を特に指定していないので、limit を引き上げる修正と削除する修正のどちらも合格にしています。
Verifier の合格条件
-
currencyコンテナの CPU limit が 20m より大きいか、limit が削除されていること -
currencyDeployment のロールアウトが完了していること - Verifier が
frontend-proxy経由で/api/currencyに 20 回リクエストを送り、p95 の応答時間が 150ms 以下 であること
quest-12 (fix-env-cleanup) — 商品画像が表示されない
- カテゴリ : workload
- 難易度 : lunatic
- 配点 : 800 pt
- ヒント : なし
シナリオ
カスタマーサポートには、ずいぶん前から「商品画像が表示されない」という問い合わせが届いていました。画像配信チームは「image-provider のマニフェストの値はおかしくないはずだ」と話しています。オブザーバビリティチームからは「image-provider の span も Jaeger に届いていない」と聞いています。商品画像が表示され、Jaeger で image-provider の span を確認できる状態にします。
障害の内容
image-provider の env が通常とは異なる状態で、初期コミットに入っています。通常の状態との違いは次の 2 つです。
# 障害が入った状態
env:
  - name: OTEL_COLLECTOR_HOST
    value: $(OTEL_COLLECTOR_NAME)       # ← 参照先より前にある
  - name: OTEL_COLLECTOR_NAME
    value: otel-collector
  - name: OTEL_COLLECTOR_PORT_GRPC
    value: "4317"
  - name: OTEL_EXPORTER_OTLP_METRICS_TEMPORALITY_PREFERENCE
    value: cumulative
  - name: OTEL_SERVICE_NAME
    valueFrom:
      fieldRef:
        fieldPath: metadata.labels['app.kubernetes.io/component']
  # IMAGE_PROVIDER_PORT が消えている
① IMAGE_PROVIDER_PORT の削除
Kubernetes の Service Discovery に関する問題です。「Kubernetes が Service から自動で環境変数を注入するので冗長」という誤解から消された、というシナリオにしています。実際には、namespace に Service image-provider があるので、kubelet が環境変数 IMAGE_PROVIDER_PORT=tcp://<ClusterIP>:8081 を Pod に注入します( enableServiceLinks はデフォルトで有効)。image-provider のイメージは起動時に envsubst で nginx の設定を展開するので、 listen tcp://172.20.x.x:8081; という設定になり、nginx が起動に失敗します。
② env のアルファベット順への並べ替え
①の修正で Web サイトの画像が表示されるようになりますが、このままでは OTel の送信が失敗し、image-provider の span が Jaeger に届きません。Kubernetes の $(VAR) は、リストの前のほうで定義した変数しか展開しません。 OTEL_COLLECTOR_HOST: $(OTEL_COLLECTOR_NAME) が OTEL_COLLECTOR_NAME より前にあるので、 $(OTEL_COLLECTOR_NAME) という文字列のまま渡ります。
①を修正すると②が表面化する二段構成としています。
観測されるはずの症状
まず、 image-provider が CrashLoopBackOff になっています。 kubectl logs <image-provider-pod> には次のエラーが出ます。
invalid host in "tcp://172.20.33.10:8081" of the "listen" directive ログに出る IP は、 kubectl get svc image-provider の ClusterIP と同じです。Kubernetes の Service Discovery の理解が必要です。
①を修正すると画像は表示されるようになりますが、Jaeger に image-provider の span は出ません。ログには次のエラーが出ます。
OTel export failure: errors resolving $(OTEL_COLLECTOR_NAME):4317想定の解き方
-
kubectl logsのlistenのエラーと、ログに出る IP が Service の ClusterIP と同じことから、Service の環境変数の自動注入にたどり着く -
IMAGE_PROVIDER_PORT: "8081"を明示的に書き戻す - ログの
errors resolving $(OTEL_COLLECTOR_NAME):4317から、$(VAR)が展開されていないことに気づき、env の順番と展開の条件を調べる -
OTEL_COLLECTOR_NAMEをOTEL_COLLECTOR_HOSTより前に移す
env:
  - name: IMAGE_PROVIDER_PORT
    value: "8081"
  - name: OTEL_COLLECTOR_NAME
    value: otel-collector
  - name: OTEL_COLLECTOR_HOST
    value: $(OTEL_COLLECTOR_NAME)
  - name: OTEL_COLLECTOR_PORT_GRPC
    value: "4317"
  - name: OTEL_EXPORTER_OTLP_METRICS_TEMPORALITY_PREFERENCE
    value: cumulative
  - name: OTEL_SERVICE_NAME
    valueFrom:
      fieldRef:
fieldPath: metadata.labels['app.kubernetes.io/component']- commit & push → ArgoCD 同期
原因をすべて理解していれば、1 回のコミットで修正できます。 OTEL_COLLECTOR_HOST に otel-collector を直接書く修正も動作するので合格にしています。
Verifier の合格条件
-
image-providerDeployment のロールアウトが完了し、Pod が 1 台以上 available であること - GM から
http://image-provider.<team-ns>.svc.cluster.local:8081/products/NationalParkFoundationExplorascope.jpgに 5 回リクエストし、すべて 200 が返ること - リクエストを送った後に、Jaeger で
image-providerの trace が見つかること(最大 30 秒待ちます。修正前の trace で合格にならないよう、検索範囲はリクエストの直前以降に限っています)
quest-13 (fix-dns-ndots) — SLO レポートが更新されない
- カテゴリ : networking
- 難易度 : lunatic
- 配点 : 800 pt
- ヒント : なし
シナリオ
SRE チームから「SLO レポートが昨日から更新されない。レポーターは毎分 Prometheus から集計しているだけで、レポーターのコードは変更していない」と連絡がありました。基盤チームは、CoreDNS の負荷対策として、ワークロードの DNS 設定の見直しを進めています。DNS の問い合わせを減らす設定は基盤チームの方針なので維持し、レポーターのコード、イメージ、起動方法、スクリプトのマウント構成、実行間隔も変更せずに解消する必要があります。
障害の内容
SRE チームの slo-reporter は、毎分 Job を起動して Prometheus にクエリを投げる CronJob です( services/slo-reporter.yaml )。Prometheus の宛先は http://prometheus.$(POD_NAMESPACE).svc:9090 と書かれています。初期状態のイメージは python:3.12-slim (libc は glibc)で、正常に動作していました。
そこへ、次の 2 つの PR が順に入りました。
- SRE チームの PR(
perf(slo-reporter): イメージを Alpine ベースにする)で、イメージがpython:3.12-alpine3.22(libc は musl)に変更される - 基盤チームの PR(
perf(slo-reporter,recommendation): ndots を 2 にして DNS の問い合わせを減らす)で、dnsConfigにndots: 2が入る
# 2 つ目の PR で入った設定
spec:
  jobTemplate:
    spec:
      template:
        spec:
          dnsConfig:
            options:
              - name: ndots
                value: "2"
ndots: 2 は、外部のサービスに接続するワークロードの Pod に設定することが EKS の ベストプラクティス で推奨されている設定です。2 つの PR はどちらか一方だけなら問題は起きず、両方が入って初めて名前解決に失敗します。
そもそも ndots は「名前に含まれるドットがこの数以上なら、そのまま FQDN として問い合わせる」という設定です。 prometheus.<ns>.svc はドットが 2 個なので、 ndots: 2 では FQDN として扱われます。このときの挙動が libc によって異なります。
- glibc : まずそのまま問い合わせ、失敗すると search domain(
<ns>.svc.cluster.localなど)を補って再試行するので、解決できる - musl : そのまま問い合わせるだけで、search domain を補わないので、
Name does not resolveになる
同じ PR で recommendation にも ndots: 2 が入っていますが、これはおとりです。 recommendation も Alpine(musl)ですが、宛先は product-catalog や flagd のようにドットを含まない名前なので、ドットの数が ndots 未満になり、search domain が補われて解決できます。
観測されるはずの症状
kubectl get cronjob,jobs,pods で、 slo-reporter の Job が毎回 Failed になっていることがわかります。Job の Pod のログには次のエラーが出ます。
SLO レポートの集計に失敗しました: url=http://prometheus.<team-ns>.svc:9090 error=<urlopen error [Errno -2] Name does not resolve>ところが、Code Server(Debian 系なので glibc)から同じ名前を引くと解決できます。
$ getent hosts prometheus.<team-ns>.svc
172.20.x.x      prometheus.<team-ns>.svc.cluster.local
想定の解き方
- Job の Pod のログで
Name does not resolveを確認し、Code Server からは同じ名前を解決できることを確かめる - コミット履歴から
ndots: 2を入れた PR を見つける。同じ PR のrecommendationは動作していることに気づく - その前の PR で slo-reporter のイメージが Alpine に変更されていることから、musl と glibc の名前解決の違いにたどり着く
- 宛先を FQDN に変更する
env:
  - name: POD_NAMESPACE
    valueFrom:
      fieldRef:
        fieldPath: metadata.namespace
  - name: PROMETHEUS_URL
value: <http://prometheus.$>(POD_NAMESPACE).svc.cluster.local:9090- commit & push → ArgoCD 同期 → 次の Job が成功し、ログに
SLO report: ...が出る
FQDN( prometheus.$(POD_NAMESPACE).svc.cluster.local )はドットが 4 個あり、そのまま問い合わせて解決できます。末尾のドットはあってもなくてもかまいません。短縮名の prometheus でも、ドットが 0 個で search domain が補われるので直ります。
Verifier の合格条件
まず、次の制約がすべて維持されていることを確認します。
- CronJob
slo-reporterが存在し、scheduleが* * * *のまま - Pod テンプレートの
dnsConfig.optionsのndotsが"2"のまま - CronJob と Job テンプレートの
suspendが有効になっておらず、startingDeadlineSecondsが未設定か 10 以上 - コンテナ
reporterのイメージがpython:3.12-alpine3.22、commandが["python", "/app/report.py"]のまま - マウントは
/appへの ConfigMapslo-reporterの 1 つだけで、ConfigMap のキーはreport.pyだけ、内容も元のまま
そのうえで、GM が CronJob のテンプレートから Job をすぐに作成し( kubectl create job --from=cronjob/slo-reporter )、その Job か検証開始後に CronJob が作成した Job が成功するのを待機します。最後に、長時間動作し続ける Job が次の定期実行を止めていないことも確認します。
GM が作成した Job は slo-reporter-verify- で始まる名前で、終了から 10 分後に削除されます。それまでは Pod のログを見られるので、不合格だったときは原因を確認できます。
ndots を戻す修正、イメージを glibc 系に戻す修正、スクリプトを差し替える修正、実行間隔を変更する修正はいずれも不合格です。
作問メンバー紹介と謝辞
CNDW2026 GameDayの環境準備や運営に携わってくださった以下の皆さまに、心より感謝いたします。皆さまのご協力があったからこそ、このイベントを開催できました。本当にありがとうございました!
- さうす さん
- Melonps さん
- 鍋島 さん
- jacopen さん
- テストプレイに参加いただいた皆さん
